 شاهین آقامعلی
الگوریتم تحلیل تفکیک خطی (Linear Discriminant Analysis یا LDA) یکی از روشهای مهم در هوش مصنوعی و یادگیری ماشین است که برای دستهبندی دادهها و کاهش ابعاد آنها استفاده میشود. این الگوریتم با بررسی تفاوت میان گروههای داده، تلاش میکند مرزی مناسب برای تفکیک کلاسها پیدا کند و در عین حال، اطلاعات مهم مربوط به تفاوت آنها را حفظ کند.
LDA در مسائلی مانند تشخیص بیماری، تحلیل دادههای مالی، شناسایی الگوها و طبقهبندی نمونهها کاربرد دارد. یکی از ویژگیهای مهم این روش آن است که هم میتواند بهعنوان یک الگوریتم دستهبندی مستقل استفاده شود و هم با کاهش ابعاد دادهها، به آمادهسازی اطلاعات برای مدلهای دیگر کمک کند. در این مقاله، نحوه عملکرد الگوریتم LDA، مبانی ریاضی، کاربردها، مزایا و محدودیتهای آن را بررسی خواهیم کرد.
الگوریتم LDA چگونه کار میکند؟
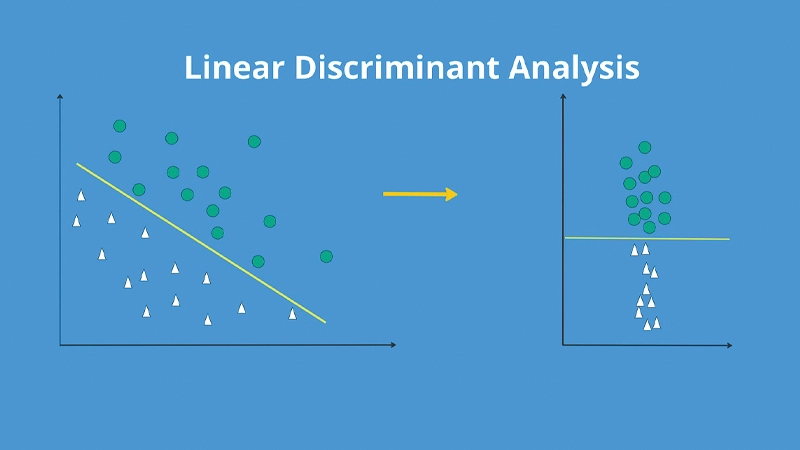
الگوریتم LDA بر این ایده استوار است که ویژگیهای دادهها میتوانند به شناسایی و تفکیک گروههای مختلف کمک کنند. برای مثال، فرض کنید مجموعهای از اطلاعات مربوط به بیماران در اختیار داریم که شامل سن، فشار خون، سطح قند خون و نتیجه آزمایش پزشکی است. هدف این است که بیماران را در دو گروه سالم و بیمار دستهبندی کنیم. LDA میانگین ویژگیها را در هر گروه محاسبه میکند و میزان پراکندگی دادهها را درون هر گروه و بین گروههای مختلف بررسی میکند. سپس ترکیبی خطی از ویژگیها را پیدا میکند که تفاوت میان گروهها را تا حد امکان افزایش دهد و پراکندگی نمونههای هر گروه را کاهش دهد. به زبان ساده، LDA به دنبال جهتی در فضای دادههاست که وقتی نمونهها روی آن تصویر میشوند، گروههای مختلف از یکدیگر فاصله بیشتری داشته باشند. این ویژگی باعث میشود الگوریتم بتواند هم برای پیشبینی کلاس دادههای جدید و هم برای سادهسازی دادههای پیچیده استفاده شود.
تفاوت LDA با PCA چیست؟
برای درک بهتر LDA، باید آن را با الگوریتم تحلیل مؤلفههای اصلی یا PCA مقایسه کنیم. هر دو روش برای کاهش ابعاد دادهها استفاده میشوند، اما هدف آنها یکسان نیست.
PCA: به دنبال جهتهایی است که بیشترین واریانس کلی دادهها را حفظ کنند؛ برای این کار به برچسب کلاسها نیاز ندارد.
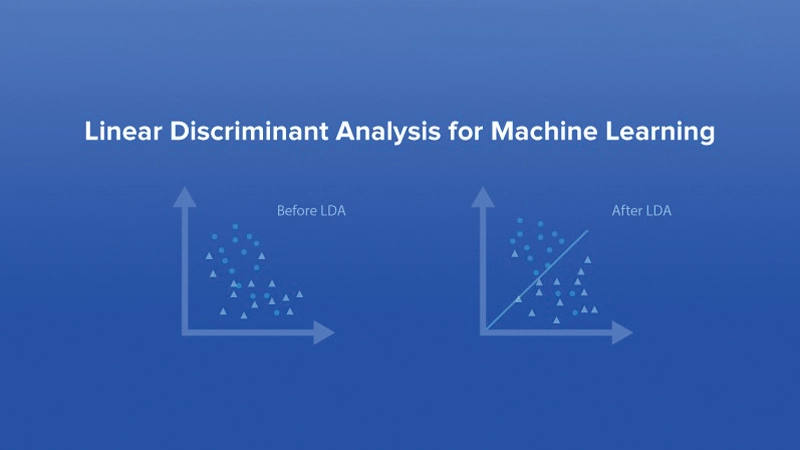
LDA: از برچسبهای کلاس استفاده میکند تا جهتهایی را پیدا کند که جدایی میان گروههای مختلف را بهتر نشان دهند.
برای مثال، اگر مجموعهای از تصاویر متعلق به سه دسته حیوان داشته باشیم، PCA ممکن است ویژگیهایی را حفظ کند که بیشترین تغییرات تصویری را توضیح میدهند؛ در حالی که LDA تلاش میکند ویژگیهایی را برجسته کند که به تفکیک این سه دسته کمک میکنند. بنابراین، اگر هدف کاهش ابعاد با تأکید بر دستهبندی باشد، LDA میتواند گزینه مناسبی باشد؛ اما اگر هدف حفظ بیشترین تغییرات کلی دادهها باشد، PCA انتخاب طبیعیتری است.
مبانی ریاضی الگوریتم LDA
برای اینکه عملکرد LDA را دقیقتر درک کنیم، باید با دو مفهوم آماری مهم آشنا شویم: پراکندگی درونکلاسی و پراکندگی بینکلاسی. این دو مفهوم مشخص میکنند که نمونههای یک گروه تا چه اندازه به هم نزدیک هستند و گروههای مختلف چه فاصلهای از یکدیگر دارند.
۱. پراکندگی درونکلاسی (Within-Class Scatter)
پراکندگی درونکلاسی نشان میدهد که دادههای متعلق به یک کلاس تا چه اندازه از میانگین همان کلاس فاصله دارند. هرچه این پراکندگی کمتر باشد، نمونههای آن گروه به یکدیگر شبیهتر هستند. LDA تلاش میکند پس از تصویر کردن دادهها روی یک محور جدید، این پراکندگی را کاهش دهد.
۲. پراکندگی بینکلاسی (Between-Class Scatter)
پراکندگی بینکلاسی میزان فاصله میانگین گروههای مختلف را نشان میدهد. هرچه میانگین کلاسها از یکدیگر دورتر باشند، تفکیک آنها معمولاً آسانتر خواهد بود. به همین دلیل، LDA به دنبال جهتی است که فاصله میانگین کلاسها را نسبت به پراکندگی درون آنها افزایش دهد.
هدف اصلی الگوریتم را میتوان به شکل زیر نمایش داد:
J(w) = (wᵀ S_B w) / (wᵀ S_W w)
در این رابطه، SB ماتریس پراکندگی بینکلاسی، SW ماتریس پراکندگی درونکلاسی و w بردار جهت تصویرسازی است. الگوریتم تلاش میکند مقداری برای w پیدا کند که نسبت بالا را بیشینه کند. در حالت کلاسیک، این مسئله با حل یک مسئله مقدار ویژه تعمیمیافته انجام میشود.
مراحل اجرای الگوریتم LDA
الگوریتم LDA برای یادگیری از دادهها چند مرحله اصلی را طی میکند. شناخت این مراحل کمک میکند بدانیم چگونه اطلاعات خام به یک مدل دستهبندی یا مجموعهای از ویژگیهای تفکیککننده تبدیل میشوند.
دریافت و آمادهسازی دادهها: ویژگیهای ورودی و برچسب کلاس هر نمونه مشخص میشوند. دادههای ناقص و مقادیر غیرعادی نیز در صورت نیاز بررسی میشوند.
محاسبه میانگین کلاسها: میانگین ویژگیها برای هر کلاس محاسبه میشود تا مرکز تقریبی گروهها مشخص شود.
محاسبه ماتریسهای پراکندگی: پراکندگی درونکلاسی و بینکلاسی محاسبه میشوند تا میزان فشردگی و جدایی گروهها اندازهگیری شود.
یافتن جهتهای تفکیککننده: الگوریتم جهتهایی را انتخاب میکند که نسبت جدایی بین کلاسها به پراکندگی درون کلاسها را افزایش میدهند.
تصویرسازی یا دستهبندی: دادهها به فضای جدید منتقل میشوند یا مدل با استفاده از توزیع احتمالی کلاسها، برچسب نمونههای جدید را پیشبینی میکند.
کاربردهای الگوریتم LDA در هوش مصنوعی
الگوریتم LDA در حوزههایی مفید است که دادهها دارای برچسب هستند و هدف، تفکیک گروهها یا استخراج ویژگیهای متمایزکننده است. البته کیفیت نتیجه به نوع داده، اعتبار فرضیات آماری و نحوه ارزیابی مدل بستگی دارد.
حوزه کاربرد | نمونه کاربرد LDA | هدف استفاده از الگوریتم | مثال عملی |
|---|---|---|---|
پزشکی و سلامت | دستهبندی بیماران بر اساس نتایج آزمایشهای پزشکی | تفکیک گروههای سالم و بیمار بر اساس ویژگیهای متمایزکننده | تشخیص احتمال ابتلا به یک بیماری با استفاده از شاخصهای آزمایشگاهی |
امور مالی و بانکداری | طبقهبندی مشتریان بر اساس ریسک اعتباری | شناسایی تفاوت میان گروههای کمریسک و پرریسک | بررسی درآمد، سابقه پرداخت و میزان بدهی برای دستهبندی متقاضیان وام |
پردازش تصویر | شناسایی چهره و تفکیک تصاویر افراد | استخراج ویژگیهایی که تفاوت میان افراد را بهتر نشان میدهند | کاهش ابعاد ویژگیهای تصاویر چهره و دستهبندی آنها |
بازاریابی و فروش | دستهبندی مشتریان بر اساس گروههای از پیش تعیینشده | شناسایی ویژگیهایی که گروههای مشتریان را از یکدیگر متمایز میکنند | تقسیم مشتریان به گروههای خریداران وفادار و کمتعامل بر اساس دادههای رفتاری برچسبدار |
علم داده | کاهش ابعاد مجموعه دادههای برچسبدار | حفظ اطلاعاتی که بیشترین نقش را در تفکیک کلاسها دارند | تبدیل مجموعهای با دهها ویژگی به تعداد کمتری مؤلفه برای تحلیل یا آموزش مدل |
تشخیص تقلب | دستهبندی تراکنشهای دارای برچسب سالم یا متقلبانه | یافتن ترکیب خطی از ویژگیها برای تفکیک دو گروه | تحلیل مبلغ تراکنش، زمان انجام و سابقه فعالیت مشتری |
پردازش زبان طبیعی (NLP) | دستهبندی اسناد و متون | کاهش ابعاد ویژگیهای متنی و کمک به تفکیک دستههای مشخص | طبقهبندی خبرها در گروههای فناوری، اقتصاد و ورزش پس از استخراج ویژگیها |
کشاورزی هوشمند | طبقهبندی نمونههای محصولات کشاورزی | تشخیص تفاوت میان گروههای محصولات بر اساس ویژگیهای اندازهگیریشده | تفکیک انواع محصولات بر اساس ویژگیهای فیزیکی یا دادههای آزمایشگاهی |
در کاربردهای پزشکی و مالی، LDA باید با دادههای مناسب و روشهای اعتبارسنجی دقیق ارزیابی شود؛ زیرا دستهبندی اشتباه میتواند پیامدهای مهمی داشته باشد. همچنین، LDA بهتنهایی تضمین نمیکند که یک مدل در دادههای جدید عملکرد مناسبی خواهد داشت.
مزایا و محدودیتهای LDA
پیش از انتخاب این الگوریتم، باید نقاط قوت و ضعف آن را در کنار یکدیگر بررسی کرد. LDA معمولاً روش مناسبی برای ایجاد یک مدل نسبتاً ساده و قابل تفسیر است، اما عملکرد آن به فرضیات آماری و ساختار دادهها وابستگی دارد.
مهمترین مزایا:
سرعت مناسب آموزش در بسیاری از مسائل معمول.
امکان دستهبندی چندکلاسه.
قابلیت کاهش ابعاد با استفاده از برچسب کلاسها.
ساختار نسبتاً ساده و قابلیت تفسیر ضرایب مدل.
مهمترین محدودیتها:
فرض میکند کلاسها از توزیعهای نرمال چندمتغیره با ماتریس کوواریانس مشترک پیروی میکنند.
در صورت وجود روابط غیرخطی پیچیده، ممکن است جداسازی مناسبی ایجاد نکند.
در دادههای دارای ویژگیهای بسیار زیاد و نمونههای کم، برآورد ماتریس کوواریانس ممکن است ناپایدار شود.
به دادههای پرت و نقض جدی فرضیات آماری حساس است.
در شرایطی که تعداد ویژگیها زیاد و تعداد نمونهها محدود است، استفاده از روشهایی مانند کوچکسازی ماتریس کوواریانس (Shrinkage) میتواند به پایداری مدل کمک کند. در کتابخانه Scikit-learn این قابلیت برای برخی از روشهای حل LDA در دسترس است.
تفاوت LDA و QDA چیست؟
تحلیل تفکیک درجه دوم (Quadratic Discriminant Analysis یا QDA) روش دیگری برای دستهبندی دادههاست که از نظر مبانی آماری به LDA شباهت دارد. تفاوت اصلی آنها در فرض مربوط به ماتریس کوواریانس کلاسهاست. در LDA فرض میشود تمام کلاسها ماتریس کوواریانس مشترکی دارند؛ بنابراین مرز تصمیم میان کلاسها خطی است. در مقابل، QDA برای هر کلاس ماتریس کوواریانس جداگانهای در نظر میگیرد و میتواند مرزهای تصمیم درجه دوم و انعطافپذیرتری بسازد. این انعطافپذیری ممکن است در بعضی مسائل مفید باشد، اما معمولاً به برآورد پارامترهای بیشتری نیاز دارد.
نتیجه گیری:
الگوریتم Linear Discriminant Analysis یکی از روشهای کاربردی یادگیری ماشین برای دستهبندی و کاهش ابعاد دادههای برچسبدار است. این الگوریتم با افزایش فاصله میان گروهها و کاهش پراکندگی نمونههای درون هر گروه، تلاش میکند ویژگیهایی را استخراج کند که برای تفکیک کلاسها اهمیت بیشتری دارند. اگر دادههای شما ساختار نسبتاً مناسبی با مرزهای خطی دارند و به مدلی سریع، ساده و قابل تفسیر نیاز دارید، LDA میتواند گزینه مناسبی باشد. با این حال، انتخاب نهایی باید بر اساس آزمون مدل روی دادههای جدید و مقایسه آن با الگوریتمهایی مانند Logistic Regression، SVM و QDA انجام شود.
منبع مقاله:

پاسخ :