 شاهین آقامعلی
گوگل از دو مدل جدید هوش مصنوعی با تمرکز بر مکالمه صوتی بلادرنگ و استدلال پیشرفته رونمایی کرده است. مدلهای Gemini 3.8 Live و Gemini 3.8 Live Extended Thinking جدیدترین تلاش گوگل برای نزدیکتر کردن تعامل انسان و هوش مصنوعی به یک گفتوگوی طبیعی، سریع و هوشمند هستند. Gemini 3.8 Live با تمرکز بر مقیاسپذیری و هزینه پایینتر طراحی شده و در کنار تواناییهای مکالمهای، از درک بصری و پردازش ورودیهای تصویری در زمان نزدیک به واقعی نیز بهره میبرد. این مدل میتواند در جریان مکالمه میان ۹۷ زبان پشتیبانیشده جابهجا شود و درک بهتری از زمینه گفتوگو ارائه دهد. یکی از قابلیتهای مهم این مدل، امکان اجرای ابزارها و APIها در پسزمینه است. به این ترتیب، مدل میتواند در حالی که یک وظیفه در حال اجراست، مکالمه با کاربر را ادامه دهد و بدون ایجاد وقفه طولانی، وضعیت انجام کار را مدیریت کند. این ویژگی میتواند برای توسعه عاملهای صوتی هوش مصنوعی (Voice Agents) کاربرد زیادی داشته باشد.
در طرف دیگر، Gemini 3.8 Live Extended Thinking برای وظایف پیچیدهتر ساخته شده است. این مدل علاوه بر مکالمه بلادرنگ، از قابلیت استدلال چندمرحلهای بهره میبرد و میتواند هنگام فکر کردن و انجام یک وظیفه، بهصورت همزمان با کاربر صحبت کند. گوگل میگوید این مدل برای گردشکارهای پیچیده و وظایفی که به تصمیمگیری و استدلال بیشتری نیاز دارند، عملکرد بالاتری ارائه میکند.
بر اساس اطلاعات منتشرشده، Gemini 3.8 Live Extended Thinking در شاخص Speech to Speech Quality Index شرکت Artificial Analysis امتیاز ۸۲.۶ را کسب کرده و در رتبه نخست قرار گرفته است. این مدل همچنین در معیار τ-Voice به امتیاز ۶۸.۶ درصد و در بنچمارک بانکی τ-Voice شرکت Sierra به ۳۵.۱ درصد رسیده است. در آزمون Big Bench Audio نیز امتیاز ۹۷.۷ درصد برای آن گزارش شده است.
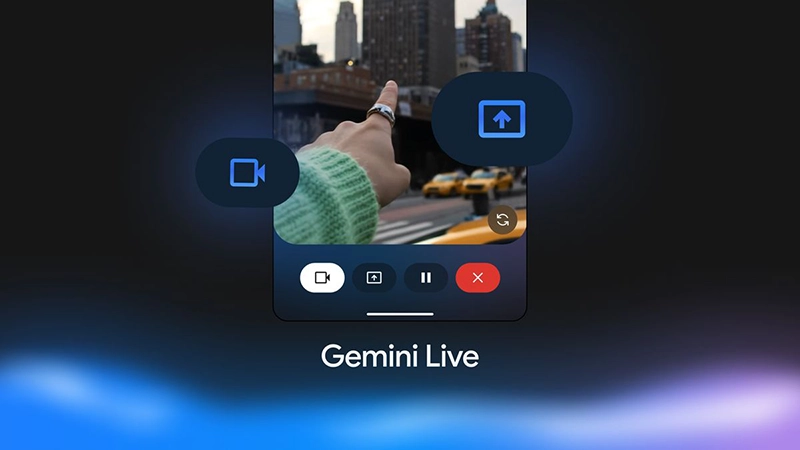
گوگل همچنین اعلام کرده که مدلهای جدید در بنچمارک EVA-Bench متعلق به ServiceNow توانستهاند میان کیفیت مکالمه و دقت در انجام وظایف پیچیده تعادل ایجاد کنند. Gemini 3.8 Live نیز در Speech Agent Arena جایگاه دوم را به دست آورده است. این مدلها تنها برای کاربران عادی طراحی نشدهاند و بخش مهمی از هدف گوگل، توسعه اکوسیستم عاملهای صوتی برای کسبوکارها و توسعهدهندگان است. API مربوط به Gemini Live اکنون توسط پلتفرمهایی مانند Agora، LangChain، LiveKit، Pipecat و Vercel پشتیبانی میشود و به توسعهدهندگان اجازه میدهد رابطهای صوتی و عاملهای هوشمند مبتنی بر مکالمه ایجاد کنند.
گوگل همچنین از همکاری با شرکتهایی مانند Salesforce، Genspark و Lumeris خبر داده است. هدف این همکاریها استفاده از قابلیتهایی مانند تأخیر پایین، مکالمه روان و فراخوانی ابزارها در کاربردهای واقعی است. در بخش ایمنی نیز گوگل اعلام کرده است که تمام فایلهای صوتی تولیدشده توسط محصولات هوش مصنوعی این شرکت با فناوری SynthID واترمارک میشوند. این واترمارک به شکل نامحسوس در صدای تولیدشده قرار میگیرد تا امکان شناسایی محتوای تولیدشده توسط هوش مصنوعی فراهم شود.
معرفی Gemini 3.8 Live و نسخه Extended Thinking نشان میدهد که رقابت در حوزه هوش مصنوعی صوتی و عاملهای هوشمند وارد مرحله جدیدی شده است؛ مرحلهای که در آن مدلهای هوش مصنوعی تنها به پاسخ دادن محدود نیستند و میتوانند همزمان با مکالمه، اطلاعات بصری را درک کنند، استدلال انجام دهند، ابزارها را اجرا کنند و وظایف چندمرحلهای را بهصورت مستقل پیش ببرند.
منبع خبر: blog.google

پاسخ :